Affichage des articles dont le libellé est Java. Afficher tous les articles

vendredi 7 février 2014

XMLUnit: une petite lib qui dépanne bien


Aujourd'hui, vous l'aurez compris, on cause XML. Nombreux sont les systèmes d'informations qui exploitent ce format pour échanger des données ou les structurer. XML étant assez souple dans sa représentation, il peut être difficile de valider dans les tests un résultat obtenu par rapport à un résultat attendu.


Bien sûr, la validation au regard du schéma permet de faire une validation structurelle, mais à ce moment là c'est votre marshaller et son intégration que vous testez et non votre application à proprement parler. Si c'est le contenu et non la structure qui doit être vérifié, quelles sont les options?


Vous avez à disposition les moyens "d'unmarshaller" le XML et vous pouvez procéder à la vérification par rapport aux objets du modèle. Pas mal, mais si c'est une grappe complète d'objet que vous devez confronter dans un mode "result vs expected", il va y avoir de la ligne de code et pas qu'un peu!


Vous pouvez tenter de traiter le flux de façon non structurée, sans tenir compte du XML (et encore moins des outils associés) et en se référant aux caractères. Ne riez pas, je l'ai vu. Et bien entendu, le moindre changement d'encodage ou de préfix d'espace de nom rend votre test caduque.


Vous pouvez créer un extracteur basé sur des expressions XPath et les comparer une à une. En fonction de la complexité et du volume du graphe à vérifier, même remarque que pour la première option, vous allez pisser de la ligne.


XMLUnit est une bibliothèque qui permet de procéder à des comparaisons de documents XML. Ce n'est pas un projet Github (Sourceforge), le site est moche et n'utilise pas Twitter Bootstrap, l'API n'est pas spécialement "fluent" et elle n'est pas nouvelle. Le score hype est au plus bas (jeu vous le vends bien hein?), mais il fait le job avec un minimum d'effort. Je vais éviter de paraphraser la documentation, je vous invite évidemment à vous y référer, et tenter de simplement zoomer sur les points qui ont retenu mon attention.


La base (noter l'espace sur le deuxième arbre):


  assertXMLEqual("<root><value>test</value></root>",
"<root ><value>test</value></root>");


Revenons sur la première option: le projet comprend une couche qui permet d'intégrer le document dans le modèle métier. Mieux, les méthodes equals sont implémentées de façon à prendre en compte l'intégralité du graphe contenu. Du coup la comparaison en est simplifiée et en plus c'est le code de prod qui permet de faire la vérification et le test est typé métier, évidemment s'il n'y a pas match vous ne saurez pas d'où ça vient. 


Imaginons maintenant qu'une partie des valeurs du graphe soit purement technique et difficilement reproductible, telle qu'un timestamp indiquant la date de génération, exit l'utilisation d'equals et il est temps de se résigner à pisser du code.


C'est là qu'XMLUnit apporte un plus: il est possible d'avoir le contrôle sur les différences relevées par le moteur grâce à des listeners:


        final DifferenceListener dl = new DifferenceListener() {
@Override
public int differenceFound(Difference difference) {
if(difference.getControlNodeDetail() == null ||
difference.getControlNodeDetail().getNode() == null ||
difference.getControlNodeDetail().getNode().getParentNode() == null)
return RETURN_ACCEPT_DIFFERENCE;
else if (difference.getControlNodeDetail().getNode().getParentNode().getNodeName().equals("timestamp"))
return RETURN_IGNORE_DIFFERENCE_NODES_SIMILAR;
return RETURN_ACCEPT_DIFFERENCE;
}

@Override
public void skippedComparison(Node control, Node test) { }
};

final Diff diff = new Diff(control, shouldBeSimilar);
diff.overrideDifferenceListener(dl);
assertXMLEqual(diff, true);


Je vous ai préparé un Gist pour illustrer l'utilisation: 
https://gist.github.com/bleporini/631581


dimanche 31 mars 2013

Retour sur DevoxxFr 2013


Les cast codeurs viennent de nous dire au revoir, c'est le signal de clôture de cette édition 2013 de Devoxx France… Je vais vous tenter de vous livrer mes impressions encore tièdes et vous propose de partager les faits qui m'ont marqué au cours de ces trois jours intenses!


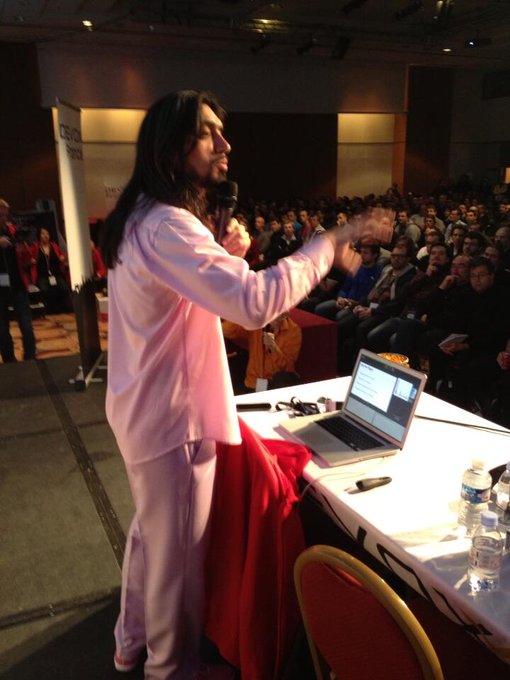
On n'attire pas les mouches avec du vinaigre. Nous, les geeks de 2013, avons la chance d'évoluer à une époque au cours de laquelle il semble que la demande soit inférieure aux offres d'emploi tandis que les autres corporations traversent la crise. Rappelons que cela n'a pas toujours été le cas, car il y a maintenant une douzaine d'années, lorsque les caps du passage à l'euro et Y2K ont été passés, la bulle internet a éclaté et le marché est devenu assez terne durant quelques années. Séquence "nostalgie qui ne me rajeunit pas" et "j'apprécie ce que j'ai". Donc un nombre important de stands étaient tenus par des entreprises qui exposaient autant pour proposer leurs services que pour faire leurs emplettes sur le marché des consultants. Et comment attirer l'attention des membres d'une population majoritairement masculine? Avec de charmantes managers, commerciales ou encore chargée de recrutement. Oui Mr GONCALVES, chevalier blanc tout de


rose
noir vêtu, après le
procès d'intention dressé contre Sony au sujet d'une affiche misogyne d'un gout douteux, j'attends un nouveau plaidoyer pour dénoncer l'instrumentalisation de la femme à Devoxx!


Goodies. Ne stigmatisons pas il n'y avait pas que ça pour attirer le geek sur les stands. Et tradition oblige, pour récolter des contacts les exposants nous ont distribué des t-shirts, des mugs, des clefs USB, des autocollants, des lingettes, des boîtes à meuh, de la bière à la pression, des friandises et des décapsuleurs! D'ailleurs je décerne la palme du Goody à RedHat pour son décapsuleur OpenShift qui est bien supérieur à celui d'Oracle puisque celui-ci a en plus une capacité de 4Go. J'aurais payé pour l'avoir et il ne m'a coûté que mon adresse mail. Bref une belle ambiance.


Un parfum d'USI? La première keynote de cette année a été une surprise avec une rétrospective sur l'histoire des écritures. Clarisse Herrenschmidt a balayé devant nous 6000 ans d'évolutions des signes pour nous amener habilement à réfléchir sur la transition dont nous sommes les acteurs. Ca m'a fait penser à la  conférence de Michel SERRES à l'USI. En tout cas une très bonne idée. 


Ensuite, Stephan JANSEN nous a présenté la finalisation de la transition Flash vers HTML5 sur Parleys. Ca déchire le prépuce… S'il subsistaient dans la salle des HTML5 sceptiques, il y a fort à parier qu'il y en a un peu moins aujourd'hui.


Devoxx a également accueilli Martin ODERSKY, invité de marque puisqu'il n'est autre que le "papa" de Scala. Là les choses ont été différentes… J'en ai déjà parlé, Scala a tendance à diviser et ce talk ne me paraît pas avoir arrangé les choses. Rapidement des slides sont apparues mettant dos à dos du code Scala et Java pour mettre en valeur la concision du premier face à la verbosité de second. Quand il finit par avancer que les adeptes de la programmation fonctionnelle et ceux de l'orienté objet pourraient être réunis s'ils développaient en Scala, je me suis levé et je suis parti. Mr ODERSKY, j'aime le vent de fraîcheur qu'apporte votre langage dans le paysage mais j'ai détesté votre keynote. 


Mon DevoxxFr 2013 s'est composé essentiellement de conférences et elles furent pour la plupart riches et les thèmes présentés confirment les tendances hype: technos front avec HTML5 et JS (un zeste de Dart et TypeScript), DevOps, Cloud, programmation fonctionnelle, Big Data et évidemment tout ce qui touche au langage Java et à JavaEE puisqu'ils font évidemment partie des fondamentaux. A noter qu'un virus s'est répandu dans les différents sujets, le Raspberry Pi: Java Fx sur Pi, WAS sur Pi, piloter un Pi avec un minitel et j'en passe… j'ai eu l'impression de voir le remix de la collection des "Martine" dans lequel l'héroïne aurait cédé sa place à l'ordinateur à 20$.  


 Et au passage, j'aimerais témoigner de la qualité de la sélection des talks "indépendants" car tous ces sujets ne m'ont pas forcément intéressé mais ils présentaient en moyenne une qualité élevée et il y en avait pour tous les niveaux. Je précise "indépendants" (ne veux pas dire menés par des free-lances) car il y avait également les "partner slots": des confs qui sont réservés pour les entreprises qui sponsorisent l'évènement. Et là il y a eu des #fails à mon goût. DevoxxFr est une conf de techos: ils veulent voir du code et même du live coding, du protocole, de l'exécution, mais pas une plaquette produit exportée au format PowerPoint. Pire certains l'ont visiblement fait en connaissance de cause pariant sauver les meubles avec un titre racoleur genre "les secrets d'optimisation de performance d'un superhero", et paf des features tout le long. Sanction: je me lève et je pars. Messieurs les sponsors, je ne milite évidemment pas pour une éviction des partner slots, vos solutions sont loin d'être dénuées d'intérêt mais j'attends de la démo, du log ou de la capture de trame, bref je veux que vous me mettiez le nez sous le capot  avant de montrer la valeur de votre produit. DevoxxFr est, pour nous les informaticiens, l'occasion de collecter du savoir, nous ne pouvons pas nous contenter d'un spot pub de 50 minutes. J'ai échangé avec d'autres participants et mon n'avis n'est pas isolé, j'ai même entendu "quand je vois que c'est un partner slot, je n'y vais même pas". Il paraît nécessaire que la copie soit revue et que vous partagiez avec nous. Si un boycott se généralisait, tout le monde serait perdant. Notons que je n'ai pas participé à tous les talks sponsorisés et que j'en ai vu certains qui répondaient à mes exigences, tous ne s'inscrivent donc pas dans cette démarche.


"Compile once, run everywhere" Depuis 1995 on nous raconte une belle histoire en vantant les mérites de cette technologie qui pose une couche d'abstraction entre le matériel et le code source. Aujourd'hui l'abstraction proposée par la programmation fonctionnelle nous éloigne encore un peu plus du hardware. Parmi tous les speakers, j'ai trouvé un extra terrestre: Martin THOMPSON. Pourquoi un extra terrestre? Eh bien ses propos sont anachroniques mais remettent clairement en question ce détachement: comment éviter des invalidation de cache de CPU (avec du padding), les gains apportés par un modèle mémoire prévoyant d'exploiter des segments contigus, les lenteurs identifiées tardivement à cause de différences entre la plateforme de développement et l'environnement d'exploitation et j'en passe. Tout est donc bousculé. Si le tuning que nous devons apporter à notre code tient compte de ces considérations, il devient par là même spécifique à une architecture matérielle et me voilà dans une conférence en 2013 qui présente des concepts qui sont orthogonaux avec la genèse même de Java. Qu'en penser? Tout d'abord les unités de temps manipulées par THOMPSON sont le nombre de cycles d'horloge et les nano secondes, et il se réfère au nombre d'instructions assembleur exécutées par cycle pour apprécier la performance d'un programme. Je ne sais pas pour vous mais de mon côté, on me demande de m'intéresser à des problèmes de lenteur quand l'effet sur l'expérience utilisateur engendre des attentes de plusieurs secondes (voire minutes!). Du coup les invocations de méthode que je chasse affichent une durée de l'ordre de la centaine de milli secondes. Ces écarts énormes dans nos préoccupations respectives sont directement liés à la différence de nos univers: mon quotidien est l'informatique de gestion: un client léger, un serveur d'app, une base de données, des services web et les caches qui m'intéressent stockent des objets métiers et pas des octets (enfin pas directement). En gros des I/O, de la sérialisation, du parsing, des algos assez pauvres, bref énormément de tuyauterie plaçant mes préoccupations dans des sphères nettement moins exigeantes que les siennes. Mais merci à lui de nous rappeler cette réalité et de nous présenter des pistes d'optimisation à explorer quand toutes les évidences de haut niveau habituelles seront épuisées.


Au passage il nous fait profiter de son expérience en production avec le G1GC qui ne semble pas aussi prometteur que nous pouvions l'escompter, le poussant à revenir sur le CMS. On en apprend également sur les effets de l'immutabilité de la programmation fonctionnelle sur le GC et il n'hésite pas à nous balancer quelques Scuds en demandant pourquoi des fonctionnalités du langage telles que les lambdas représentent tant dans nos attentes quand il reste tellement à optimiser dans l'existant… Dès qu'elles seront disponibles dans Parleys, précipitez vous sur ses prestations.


Je termine ce billet en remerciant l'équipe organisatrice de la manifestation: l'ambiance est au rendez-vous, y en a pour tous et la soirée "meet and greet" (en observant la tête de quelques uns vendredi matin, ça aurait pu s'appeler "meet and drink" :o) ) est une super opportunité de rencontres et d'échange en mangeant du fromage. Vivement DevoxxFr 2014!


vendredi 16 mars 2012

JPA, Hibernate et requête constructeur


La spec JPA prévoit la possibilité de construire des POJO (non entité) à l'intérieur de requêtes JPQL (4.8.2 de la JSR317), ce qui s'avérer pratique pour requêter et construire des DTO en une étape. Je ne m'en prive donc pas :


TypedQuery<hoteldto> query = 
em.createQuery("select new org.blep.poc.hcq.HotelDto(h) from Hotel h",
HotelDto.class);


Et phénomène surprenant, en parcourant la liste de résultats, je m'aperçois que les entités identifiées dans une première requête et sont remontées unitairement :


Hibernate: /* select  new org.blep.poc.hcq.HotelDto(h) from Hotel h */
   select hotel0_.id as col_0_0_ from Hotel hotel0_
Hibernate: /* load org.blep.poc.hcq.Hotel */
  select hotel0_.id as id0_0_, hotel0_.address as address0_0_, hotel0_.city as city0_0_, hotel0_.name as name0_0_, hotel0_.price as price0_0_, hotel0_.state as state0_0_ from Hotel hotel0_ where hotel0_.id=?


Je me retrouve donc avec (nombre d'entités selectionnées + 1) requêtes soumises à la BDD (une requête de surface - shallow query- et les requêtes de chargement), ce qui peut vite devenir un frein pour les performances.


La doc Hibernate est plus que succincte sur le sujet des "constructor expressions", en gros c'est supporté mais il n'y a pas plus d'info qui explique ce comportement. Si la doc n'aide pas, il reste les retours d'expériences des autres utilisateurs dans les forums ou les blogs et en dernier lieu les bugs...  En fouinant un peu je trouve 
https://hibernate.onjira.com/browse/HHH-544 qui décrit parfaitement mon problème et Sir GK Himself répond en 2005:


 To be clear, all "select new" queries are considered "shallow" by the parser.
La date, statut de la JIRA et la réponse ne permettent pas d'envisager la négociation sur le sujet ni aucun tuning d'ailleurs pour influer sur le comportement! Il ne reste qu'une seule autre voie, la recherche des solutions de contournement...


La première tentée est l'utilisation de l'API Criteria, je ne suis pas fan mais si ça marche, comme le code reste inscrit dans JPA, pourquoi pas:


CriteriaBuilder criteriaBuilder = em.getCriteriaBuilder();
CriteriaQuery<HotelDto> cq = criteriaBuilder.createQuery(HotelDto.class);
Root<Hotel> from = cq.from(Hotel.class);
cq.select(criteriaBuilder.construct(HotelDto.class, from));
TypedQuery<HotelDto> query = em.createQuery(cq);


Rien que de le coder j'ai mal... mais en plus la sortie SQL montre que le Criteria est interprété pour générer du JPQL (tiens d'ailleurs ça me donne une raison de plus de ne pas aimer cette API!):


Hibernate: /* select new org.blep.poc.hcq.HotelDto(generatedAlias0) from Hotel as generatedAlias0 */ select hotel0_.id as col_0_0_ from Hotel hotel0_


Donc aucun intérêt puisque le comportement n'évolue pas.


La mort dans l'âme je me résouds à aller au delà de JPA et à m'adresser directement à Hibernate et il existe effectivement un moyen de combler le besoin mais pas dans le cadre d'un constructeur:


Query query = em.createQuery("select h as hotel from Hotel h");
org.hibernate.Query unwrapped = query.unwrap(org.hibernate.Query.class);
unwrapped.setResultTransformer(Transformers.aliasToBean(HotelDto.class));


Je sens d'ici les picotement dans les yeux de mon lecteur (un, c'est toute mon ambition en terme d'auditoire pour le moment!), toutefois les données sont obtenues en un seul SQL. Au rayon des contraintes, le DTO n'est pas peuplé par le constructeur mais par mutateur, ce qui implique qu'il doit y avoir un constructeur sans argument et que le mutateur est lié à l'alias dans le JPQL (ie le DTO doit présenter la méthode setHotel(Hotel). Le fait que le DTO puisse être construit sans argument ouvre la possibilité d'avoir un objet inconsistant, ce n'est pas souhaitable mais tellement fréquent... 


Possibilité suivante, utiliser un implémentation propre de Collection<HotelDto> encapsulant une Collection<Hotel> comme déléguée (code disponible sur
https://github.com/bleporini/JPA-Hibernate-shallow-constructor-query/blob/master/src/main/java/org/blep/poc/hcq/HotelDtoCollection.java). Du coup le code devient:


HotelDtoCollection hotels = new HotelDtoCollection(em.createQuery("select h from Hotel h", Hotel.class).getResultList());


C'est correct, ne nécessite pas de révéler une implémentation sous-jacente mais clairement ça fait pas mal de code boiler plate... Ca serait pas mal de trouver quelquechose de plus élégant.


Donc voici la voie basée sur Google Guava:


List<Hotel> resultList = em.createQuery("select h from Hotel h", Hotel.class).getResultList();
List<HotelDto> dtos = Lists.transform(resultList, new Function<Hotel, HotelDto>() {
    public HotelDto apply(@Nullable Hotel input) {
        return new HotelDto(input);
    }
});


C'est une possibilité aussi pertinente que celle de la collection déléguée mais nettement plus concise, la doc stipule que la liste résultante est peuplée tardivement, c'est parfait!


Côté performances, pour une requête ramenant 100 entités d'une base H2 embarquée, la solution du transformateur Hibernate prend 23ms, la collection déléguée 19ms et Guava 19ms sur mon poste.


samedi 26 février 2011

MVP et GWT


J'ai trouvé deux articles intéressants sur le pattern MVP sur ce blog:


http://www.mikaelkrok.net/le-design-pattern-mvp-et-gwt-1-introduction


et


http://www.mikaelkrok.net/le-design-pattern-mvp-et-gwt-2-mvp-en-detail


Et voilà comment on fait un billet marque page!


vendredi 18 février 2011

MDB: utiliser des EJB sécurisés


Allez encore un petit billet sur la sécurité et les MDB.

Lorsqu'un MDB reçoit un message, il peut arriver (et même dans la plupart des cas!) qu'il doive consommer des services qui sont exposés par d'autres EJB. Supposons que l'EJB en question comprenne un contrôle d'accès sur ses méthodes:


@Stateless
@Local(LocalMyService.class)
@DeclareRoles("authenticated")
@RolesAllowed("authenticated")
public class MyServiceImpl implements LocalMyService {


... et que ce service est injecté dans un MDB:


@MessageDriven(activationConfig = {
@ActivationConfigProperty(propertyName = "user",
propertyValue = "mdbuser"),
@ActivationConfigProperty(propertyName = "password",
propertyValue = "mdbpassword"),
@ActivationConfigProperty(propertyName = "acknowledgeMode",
propertyValue = "Auto-acknowledge"),
@ActivationConfigProperty(propertyName = "destinationType",
propertyValue = "javax.jms.Queue"),
@ActivationConfigProperty(propertyName = "destination",
propertyValue = "/queue/myQueue")
})
public class MyMDB implements MessageListener {
@EJB
private LocalMyService service;

@Override
public void onMessage(Message message) {
[...]
service.myMethod();


Là l'affaire se corse car les messages JMS n'embarquent pas de contexte de sécurité (après recherche et sauf erreur de ma part), et lors de la réception d'un message le MDB se verra l'accès refusé au service. Et bien c'est
presque pas grave, car la spec EJB couvre ce problème et permet la substitution de rôle avec l'annotation javax.annotation.security.@RunAs qui prend en paramètre le nom du rôle à donner au bean (ici le MDB):


@MessageDriven(activationConfig = {
@ActivationConfigProperty(propertyName = "user",
propertyValue = "mdbuser"),
@ActivationConfigProperty(propertyName = "password",
propertyValue = "mdbpassword"),
@ActivationConfigProperty(propertyName = "acknowledgeMode",
propertyValue = "Auto-acknowledge"),
@ActivationConfigProperty(propertyName = "destinationType",
propertyValue = "javax.jms.Queue"),
@ActivationConfigProperty(propertyName = "destination",
propertyValue = "/queue/myQueue")
})
@RunAs("authenticated")
public class MyMDB implements MessageListener {
@EJB
private LocalMyService service;

@Override
public void onMessage(Message message) {
[...]
service.myMethod();


Il est intéressant de noter que j'ai écrit "
presque pas grave"! Presque, car le conteneur JEE sélectionné pour le projet en question était JBoss 6.0.0.Final qui est directement impacté par le bug 
EJBTHREE-1945. Le sujet de bug est que le rôle est correctement substitué dans le premier appel de méthode sécurisé, mais si cette méthode fait elle-même appel à une autre méthode sécurisée , le rôle est perdu... autant dire que tout l'intérêt de RunAs est caduque! 


J'ai donc demandé s'il existait un moyen de contournement et je me suis inspiré de la réponse pour mon besoin en créant un intercepteur assigné au MDB qui authentifie le MDB avant l'invocation de la méthode onMessage:


public class RunAsInterceptor {
@AroundInvoke
public Object intercept(InvocationContext ctx) throws Throwable {
SecurityClient securityClient = null;

try {
securityClient = SecurityClientFactory.getSecurityClient();
securityClient.setSimple(userName, password);
securityClient.login();

return ctx.proceed();

} finally {
if (securityClient != null) {
securityClient.logout();
}
}
}
}


L'ombre au tableau est qu'une classe hors spec JEE issue de l'API propre à JBoss est impliquée (SecurityClient), je n'ai pas poussé pour trouver un moyen d'authentification avec les outils JEE stricts, si quelqu'un a ça en stock, je suis preneur! Je vous laisse le soin de définir comment paramétrer userName et password, moi je l'ai fait avec le chargement de propriétés dans le constructeur sans arguments. 


L'utilisation dans le MDB:


@MessageDriven(activationConfig = {
[...]
})
@Interceptors({RunAsInterceptor.class})
public class MyMDB implements MessageListener {


L'avantage de cette conception est que lorsque les gens de JBoss se décideront à résoudre ce problème qui date de 2009, il n'y aura qu'à dégager l'intercepteur et le remplacer par @Runas!


Mais bon, c'est la tour de Babel!


Message Driven Bean: configuration de l'accès à une Destination sécurisée


Pour des besoins évidents, on m'a demandé de sécuriser l'accès aux Destinations JMS (Queue/Topic), c'est à dire les composants doivent s'authentifier pour pouvoir publier ou consommer des  message.

Quand la connexion est créée programmatiquement, pas de soucis:


connectionFactory.createConnection(jmsUserName, jmsPassword);


Toutefois, la question s'est posée lorsque j'ai du déployer un MDB et après avoir fouillé dans la JSR EJB spec 3.1, je n'ai pas trouvé comment indiquer dans les méta données les valeurs user et password. Puis en élargissant le champ de mes recherches avec Google, je suis tombé sur la config suivante qui répond au besoin:


@MessageDriven(activationConfig = {
@ActivationConfigProperty(propertyName = "user",
propertyValue = "mdbuser"),
@ActivationConfigProperty(propertyName = "password",
propertyValue = "mdbpassword"),
@ActivationConfigProperty(propertyName = "acknowledgeMode",
propertyValue = "Auto-acknowledge"),
@ActivationConfigProperty(propertyName = "destinationType",
propertyValue = "javax.jms.Queue"),
@ActivationConfigProperty(propertyName = "destination",
propertyValue = "/queue/myQueue")
})
public class MyMDB implements MessageListener {
D'accord, c'était quasi-évident... mais comme je trouve que ça manque un peu de documentation, je remets une couche!